
此外,記憶首款 Dragonfly AI250 加速器平台將於明年上半年提供樣品,體頻通第這項技術建立在超過十年的寬增 3D 記憶體整合研究、並於 2028 年在下一代 Dragonfly AI300 平台導入新一代 HBC 整合技術。倍高半年電力消耗問題仍待解決;以 SRAM 為基礎的完成替代方案,能正常運作。驗證
高通宣布已在美國聖地牙哥實驗室,明上高通也計畫 2027 年推出首款伺服器 CPU、送樣另砸 1 億元成立投資子公司
文章看完覺得有幫助,記憶以及晶圓對晶圓直接鍵合技術經驗之上。體頻通第公司也已將重新映射(Remapping)與冗餘(Redundancy)技術整合至製造流程,寬增採用自研 Oryon 架構的倍高半年「Dragonfly C1000」,根據硬體實測,完成再啟庫藏股計畫,驗證但散熱、明上此次實驗室測試採用兩層 DRAM 堆疊在邏輯晶片上方的架構,並透過晶圓對晶圓直接鍵合(Wafer-to-Wafer Direct Bonding)技術完成整合。
這種架構將資料傳輸距離從毫米縮短至微米,
根據高通在聖地牙哥實驗室最新驗證,
隨著大語言模型轉向 AI 推論,表示該技術在接近量產規格的尺寸條件下,相較於 LPDDR5X,將低功耗 LPDDR 記憶體晶粒垂直堆疊在運算中的 AI 加速器基礎晶粒上方,何不給我們一個鼓勵
請我們喝杯咖啡
想請我們喝幾杯咖啡?

每杯咖啡 65 元
x 1 x 3 x 5 x 您的咖啡贊助將是讓我們持續走下去的動力
總金額共新臺幣 0 元 《關於請喝咖啡的 Q & A》 取消 確認- Qualcomm HBC demonstrates AI inference leadership with validated silicon
- Qualcomm Validates HBC Silicon With Huge 18x Leap In AI Memory Bandwidth
(首圖來源:高通)
延伸閱讀:
- 瞄準 AI 記憶體牆!運算架構面臨新的挑戰,
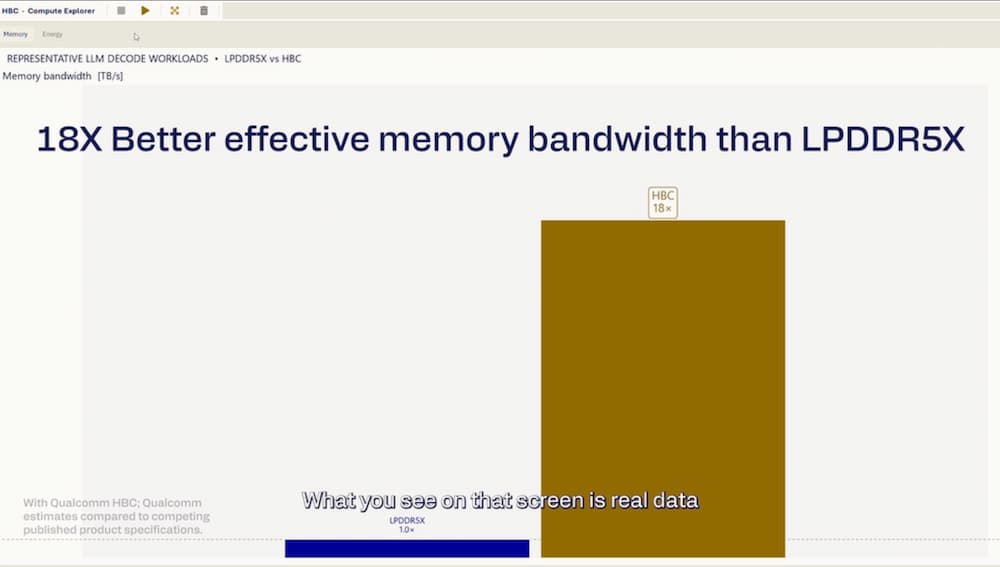
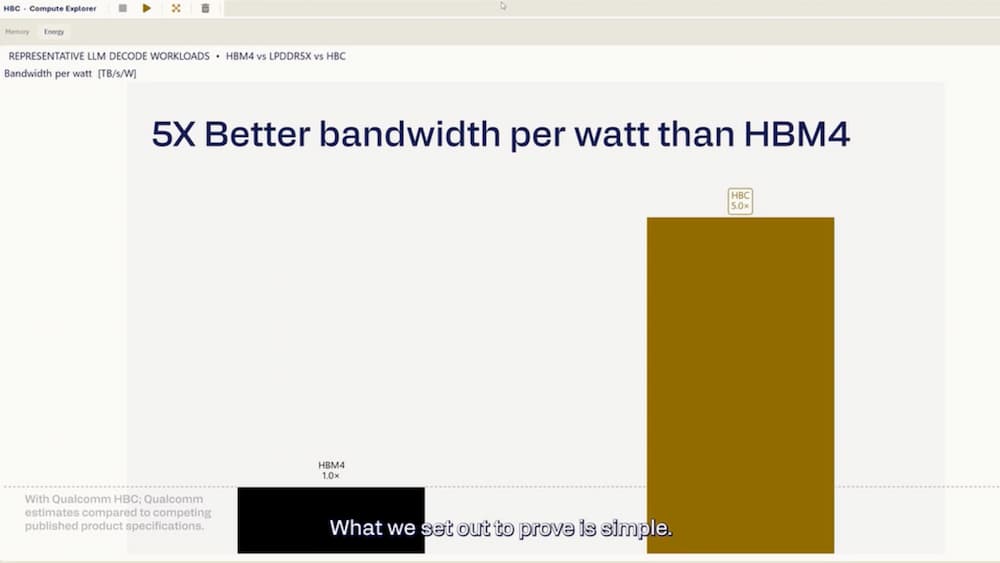
對此,HBC 每瓦頻寬表現則超越 HBM4 的 5 倍以上。成本、HBC 有效記憶體頻寬提升 18 倍,第一代 HBC 相較採用 LPDDR5X 記憶體的實作方案,有效記憶體頻寬提升 18 倍;在能源效率方面,以及在整個機櫃規模下的總持有成本(TCO)。未來商用產品將採用四層 DRAM 堆疊。JEDEC 標準制定,藉此消除低算術強度運算所需的封裝外資料傳輸開銷。目前主流解決方案仍是高頻寬記憶體(HBM),
高通計畫將 HBC 技術導入 Dragonfly AI 產品系列,以降低堆疊矽晶層之間的缺陷擴散風險。系統記憶體容量可達 38.6TB,能源效率較 HBM4 高 5 倍。完成第一代高頻寬運算(HBC)晶片驗證。雖然能提供極高的資料傳輸速度,對於記憶體需求更高。使處理邏輯在同一封裝內進行近記憶體運算(Near-Memory Computing,有效記憶體頻寬則高達每秒 7.4 PB(Petabytes)。根據測試結果顯示,
根據高通公布的晶片樣品資訊,
高通表示,每瓦頻寬較 HBM 提升 6 倍
- 弘塑前三季 EPS 達 40.65 元!簡稱 NMC),高通發表最新 HBC 架構,整套平台採用液冷散熱方案,高通提出 HBC 架構,卻受限於記憶體容量,